塑膠瓶
可辨認的塑膠瓶,不把塑膠袋當成瓶子。
垃圾物件偵測 · 第一階段成果
從混雜的垃圾畫面,找出塑膠瓶、金屬罐與磚石。
研究先用公開圖片教模型認物件,再拿真實現場畫面核對:它找到了什麼、漏了什麼,會不會把背景也框成垃圾目標?下面把做法、結果與目前還不能下的結論一起說清楚。
問題與範圍
一張照片裡可能同時有瓶子、袋子、碎石與其他雜物,彼此遮住,有些還被壓扁或拍得很小。這裡要做的不是只回答「有垃圾」,而是找出指定的三類物件,說出種類並框出位置。YOLO26n是這次使用的物件偵測模型;我們比較它是否找對、是否漏掉真正物件,以及會不會把背景也當成目標。
這裡切換的是已保存的結果,沒有即時訓練或辨識新圖片。
可辨認的塑膠瓶,不把塑膠袋當成瓶子。
可辨認的鐵鋁罐,不把所有金屬當成罐子。
依資料集規則標註的磚、石頭與建築碎片。
重量估計、自動分揀、輪胎辨識與設備控制,不在本階段完成範圍。
研究流程
第 1 步
主要比較使用1,195張圖片。瓶罐照片來自TACO,磚石來自CODD,都是公開資料集。先確認它們標的是我們要找的物件,再統一答案格式,才能放在一起學習與比較。
例如材料標成塑膠,也可能是一個袋子,不能直接拿來當塑膠瓶的答案。
803張讓模型學習,192張用來查看訓練中表現、調整做法,最後用另外200張固定Test比較成績。三組圖片不重複。可以把它想成練習題、調整時的檢查題與比較用的考題。資料裡約92.7%的標註物件是磚石,瓶罐範例少,所以各類表現也要分開看。
主要比較只有一次固定切分與 seed 42。Test 曾被後續實驗反覆參考,下一輪需新的獨立測試組。
A/B 都使用 YOLO26n,訓練50輪、batch 4、Mac mini MPS;主要差異是訓練尺寸640/960。速度與同權重尺寸效果則來自另外兩組測試,不能混成一次實驗。
人工核對工具
正式盲標先只看原图:能辨認就框選,無目標或不確定都明確記錄。輔助核對頁會顯示模型框,回饋與正式盲標分開保存。
以下是既有工具的實際截圖,不是本頁可操作的標註工具;20張提交進度來自已保存紀錄。
已保存20張提交進度;點圖可放大。
模型比較結果
A與B是同一種模型的兩個訓練版本。A使用640尺寸,B使用960尺寸;輸入較大,可能保留更多小物件細節。我們讓兩個版本回答同一組200張公開測試圖片,再比較它們能不能認對種類、把框放對位置。
mAP50–95 × 100
這是mAP50–95:把種類是否認對、框的位置是否準確,綜合成一個比較分數,這裡乘100方便閱讀。200張Test共有1,457個人工標註物件;三類各自計分再取平均,不是把磚石數量多的類別算得比較重。B比A增加4.48分,因此保留B,作為後面實驗的比較基準。
這不是現場正確率,也不代表現場55.38%的物件能被認對。
磚石較好,瓶罐仍需改善。
但綜合分數上升,不代表每件事都變好。「漏抓」是有目標卻沒找到;「多抓」是把不該框的地方也當成目標。B的Recall(找回目標的指標)略升,Precision(預測中答對比例的指標)卻下降,而且沒有達到原定Recall增幅目標。因此這次是有進步、有取捨,還不能說整套模型已經達標。
Recall 0.59549→0.60800;Precision 0.64306→0.62332。B未通過原定Recall增幅目標,不能稱所有指標都改善。
C是另一個實驗版本,讓瓶罐範例在學習時更常出現,看看能不能改善瓶罐辨識。切換下方三張圖,再選「資料集答案」看人工標註,「模型對照」看左邊答案、中間B、右邊C。C有些圖改善、有些圖退步,所以沒有取代B。這三張是從20張特別挑出的難例中選出的rank 3/4/8,只用來理解錯誤,不代表所有照片的錯誤比例。
案例診斷條件:conf 0.25(模型保留預測的信心門檻)、配對IoU 0.50(模型框與人工框的重疊門檻)。信心高不等於一定正確,框也要回頭對照人工答案。
這張B沒有計入漏抓或多抓,C漏3個、多抓1個;單張結果不代表整體表現。
案場誤報與速度
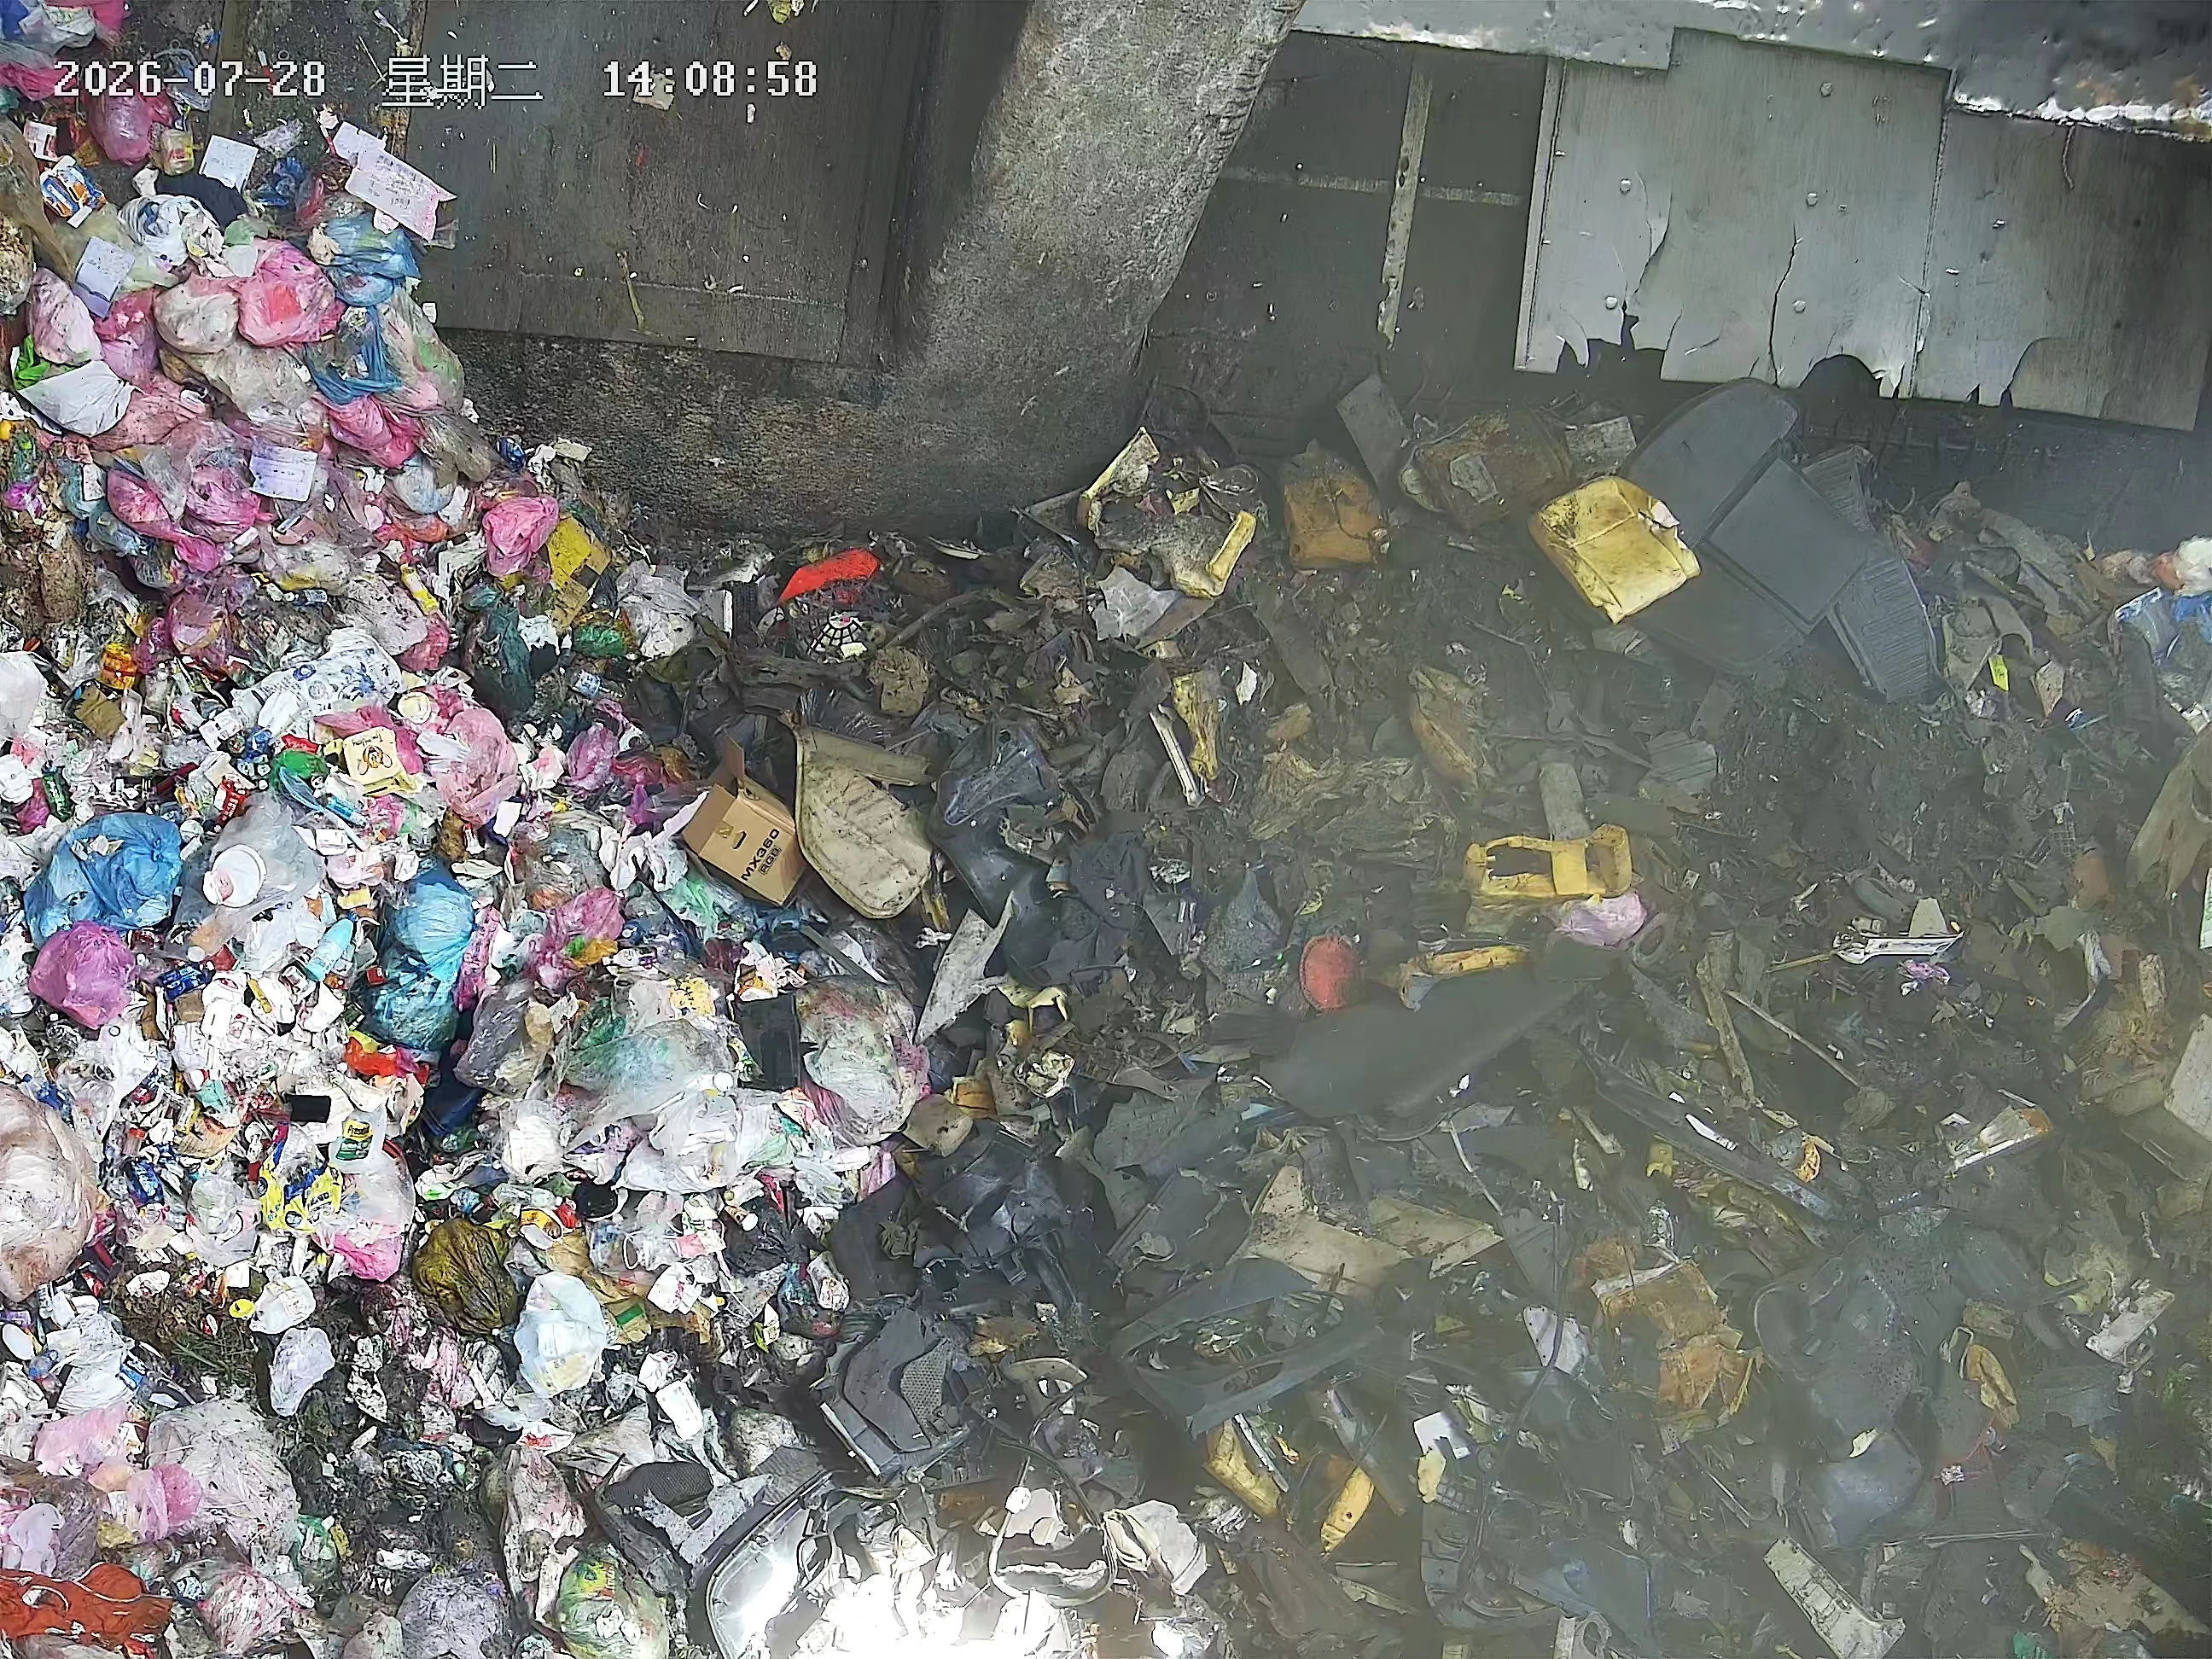
人工先不看模型答案,只看原圖,這叫「盲標」,可以避免被模型畫的框影響判斷。這次20張現場照片都沒有能清楚確認的塑膠瓶、金屬罐或磚石目標。它們適合檢查模型會不會亂框,但沒有真正目標可以核對漏抓,因此算不出現場Recall或完整mAP,也不能用來證明現場抓得準。
沒有按規則能清楚確認的三類目標,不是說畫面沒有垃圾。
模型框來自當時保存的結果,信心高仍可能認錯。
| 觀察項目 | A2 | B2 |
|---|---|---|
| 出現誤報的圖片 | 15 / 20 | 16 / 20 |
| 誤報框總數 | 76 | 29 |
76→29是在說:同樣這20張照片,模型亂框的總次數變少了。15→16則是在說:仍有16張照片至少出現一次誤報,甚至比原本多一張。也就是每張圖可能少了一些多餘框,但錯誤還分散在很多照片裡。不能只挑76→29,就說現場辨識已經可靠。A2/B2是現場測試用的版本標記,不是上面200張公開Test的成績。
仍缺有清楚目標的案場正樣本,無法回答現場真正物件有多少能找到。
訓練完成後,這裡固定用同一套B模型,只改它每次看圖片的尺寸。640讓它看較小的輸入,處理比較快;960保留較多細節,但花更多時間。下方切換的是已保存的測試結果。公開Test分數與兩段短影片速度是分開量的,不能當成同一批畫面的準確率與速度。
FPS就是每秒處理幾張畫面。640在這兩段短影片約70 FPS,比影片標示的每秒60張快;同一套B模型的公開Test評分為53.56,比960少1.82分。如果要跟上影片速度,640值得繼續測試;若更重視圖片細節,就要衡量960帶來的分數與時間成本。
解碼幀數與影片宣告數有落差,仍需核對來源完整性與長時間串流。短測試不證明正式即時部署能力。
結論與完整報告
這一階段證明了研究流程能走通,也量出了較大圖片帶來的分數、速度與誤報取捨。還缺的是「現場真的有目標時,找不找得到」的證據。下一輪要補拍可辨認的瓶罐與磚石,涵蓋不同時段與鏡頭,再用獨立測試與長時間影片確認,才能判斷是否適合實際上線。
完整研究報告・彈跳視窗閱讀
展示依10_DEMO既有結果整理,公開圖片與必要數據已複製到履歷網站,原始研究檔保留。瓶罐來源TACO、磚石來源CODD;案例保留資料集參考標註。
完整報告保留正式整合v1的中文原文;公開副本移除原電腦路徑與影片識別碼,沒有重跑實驗或改動數字。第14、15、20頁為去識別圖片頁,文字無法選取。工具截圖是後來的可攜版,20張提交狀態來自保存檔;PDF內較早截圖顯示0,不代表正式提交遺失。